2026 机器学习基础理论研讨会于 7 月 3 日至 5 日在清华大学吕大龙楼 705 会议室召开。本次研讨会由清华大学统计与数据科学系、清华大学交叉信息研究院、北京大学王选计算机研究所联合主办,上海无问芯穹智能科技有限公司支持。清华大学统计与数据科学系杨朋昆副教授、清华交叉信息研究院张景昭助理教授、北京大学王选计算机研究所张辉帅助理教授联合发起并组织。会议围绕机器学习基础理论、基础大模型、生成式 AI、高维统计、信息论、优化与强化学习等前沿方向,邀请海内外学者开展学术交流。
会议伊始,清华大学统计与数据科学系陈松蹊院士致开幕辞,回顾了清华统计学科的发展脉络和统计系建系以来在学科建设、人才培养与交叉研究方面的积累。
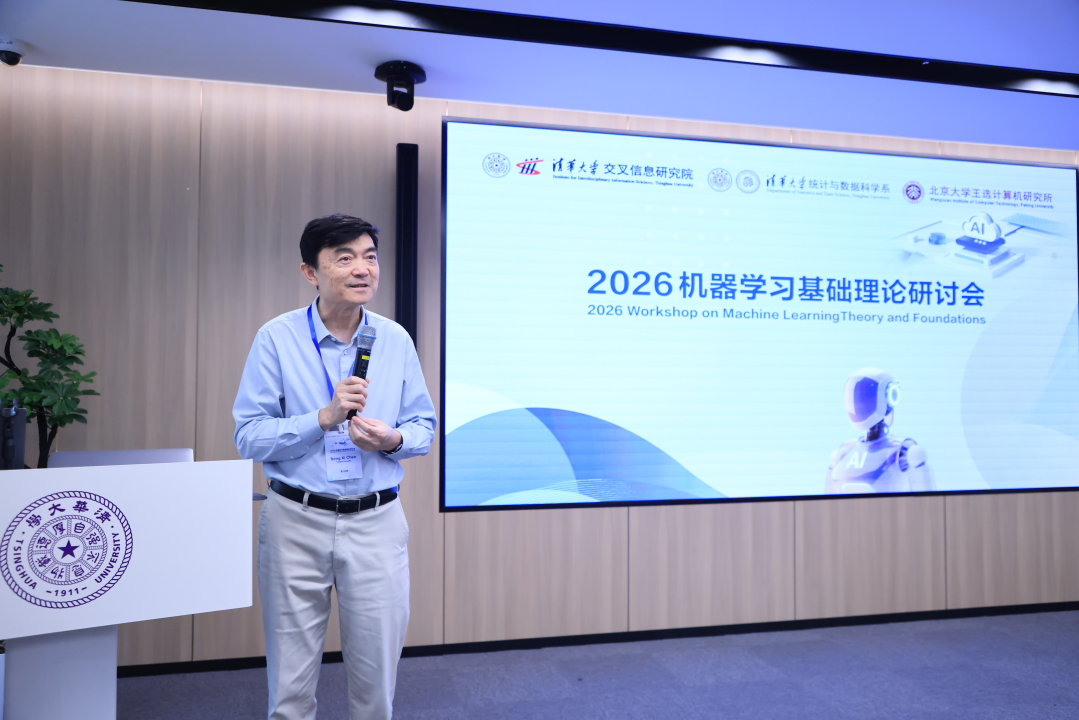
陈松蹊院士致开幕辞
加州大学圣迭戈分校Mikhail Belkin教授以"Feature Learning and the Linear Representation Hypothesis for Steering and Monitoring LLMs"为题,围绕大语言模型中的特征学习与线性表示假说展开讨论,介绍了特征学习方法如何帮助研究者在模型激活空间中识别、监测并引导特定行为,为理解和调控大模型提供新的理论视角。
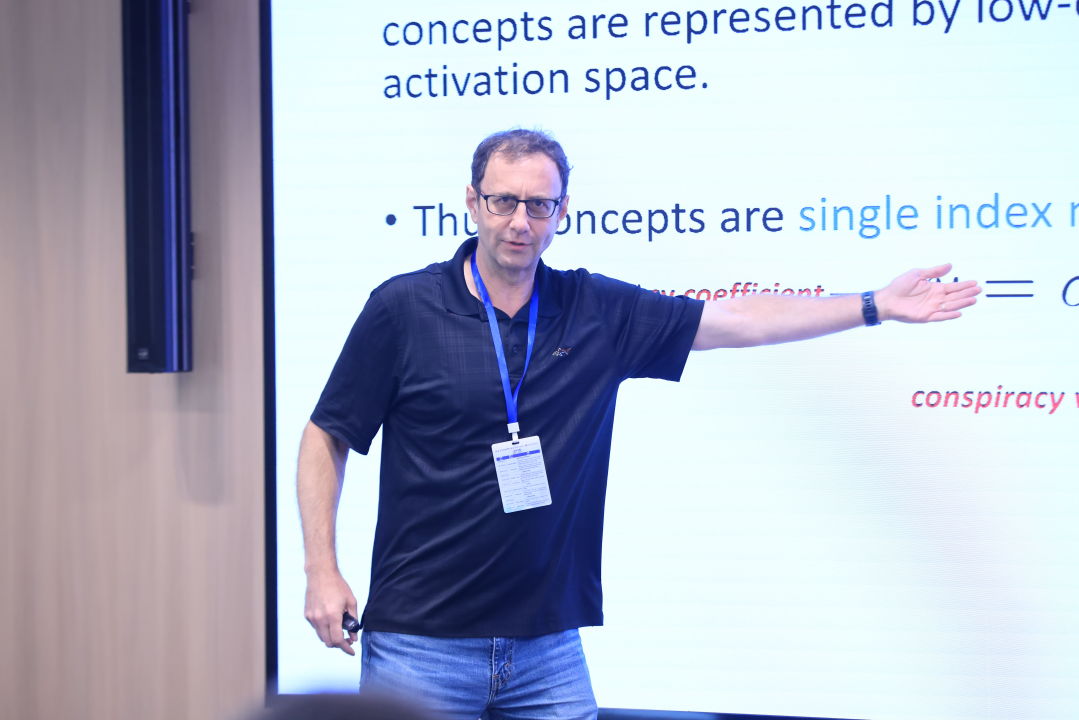
Mikhail Belkin教授进行报告
耶鲁大学Yihong Wu教授作题为"Next-symbol Prediction from Compression: Information-theoretic Optimality and Practical Algorithms" 的报告。他从通用压缩与信息论的角度分析现代生成模型中的下一符号预测问题,讨论了不同情形下的极小极大预测风险、最优预测方法以及相关计算复杂性,为依赖数据情形下的预测理论提供了系统框架。
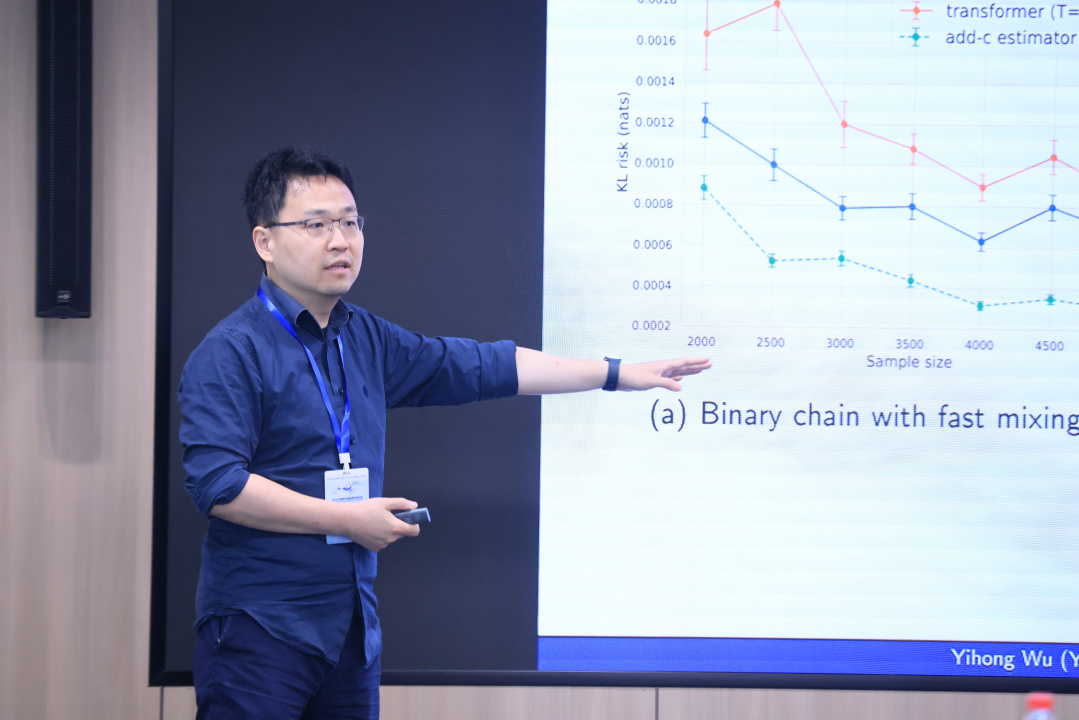
Yihong Wu教授进行报告
俄亥俄州立大学Yingbin Liang教授作题为"Accelerating and Aligning Diffusion Models: Breaking Sampling Barriers and Optimizing Fine-Tuning"的报告,聚焦扩散模型的采样加速与奖励驱动微调。她介绍了离散扩散模型采样复杂度的分析框架以及PPO式微调中随机性、探索与稳定性之间的关系,为高效、可控和奖励对齐的生成模型提供理论支撑。
Yingbin Liang教授进行报告
北京大学方聪助理教授以"Mild Over-Parameterization Benefits Tensor PCA"为题,讨论适度过参数化如何改善张量主成分分析中的梯度下降方法。他的报告展示了在对称与非对称设置下,适度过参数化能够降低样本复杂度、改善统计效率,并缩小统计可行性与计算可行性之间的差距。
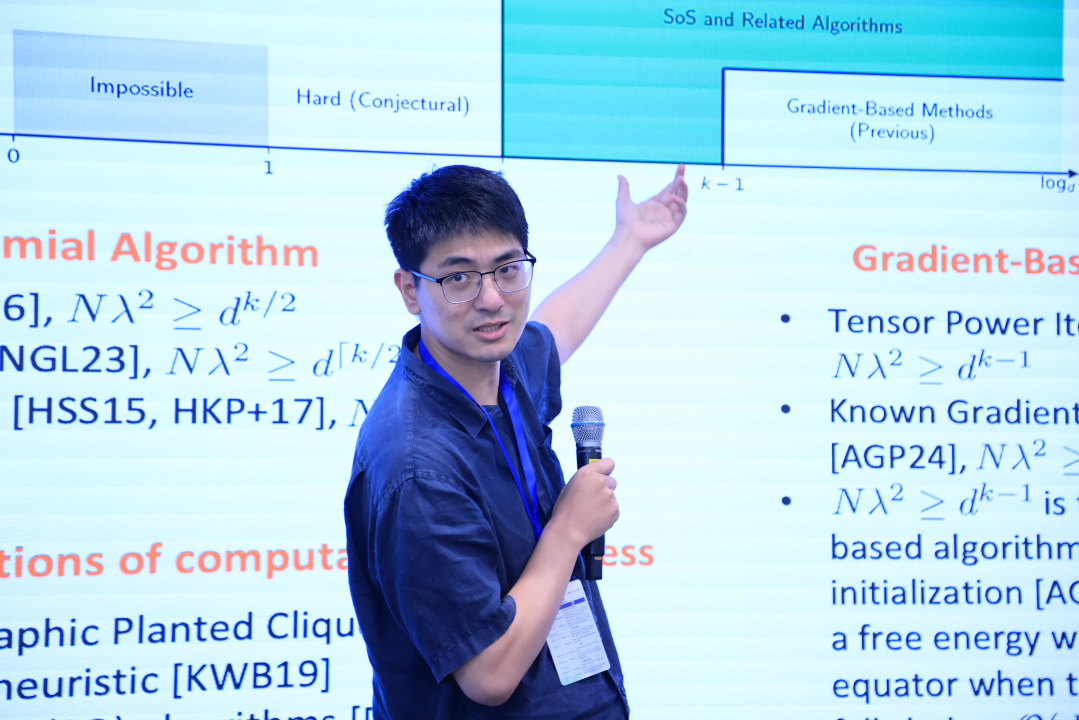
方聪助理教授进行报告
瑞士洛桑联邦理工学院Volkan Cevher教授作题为"Training Neural Networks at Any Scale"的报告。他围绕深度学习中的规模化训练问题,讨论数据、算力、网络结构和数值优化算法之间的相互作用,强调在大模型训练中需要以严谨理论支持可验证的尺度律假设,并通过统一的优化算法视角理解不同领域中深度学习训练方法的共同机制。
Volkan Cevher教授进行报告
耶鲁大学Yuejie Chi教授以"How RLVR Elicits Long-horizon Reasoning: A Learning Dynamics Perspective"为题,介绍强化学习可验证奖励(RLVR)如何激发大模型的长程推理能力。她从训练动力学出发,解释混合难度任务如何在优化过程中形成隐式课程学习,并讨论难度谱平滑性、relay regime与grokking型相变等现象,为理解推理模型训练机制提供理论解释。
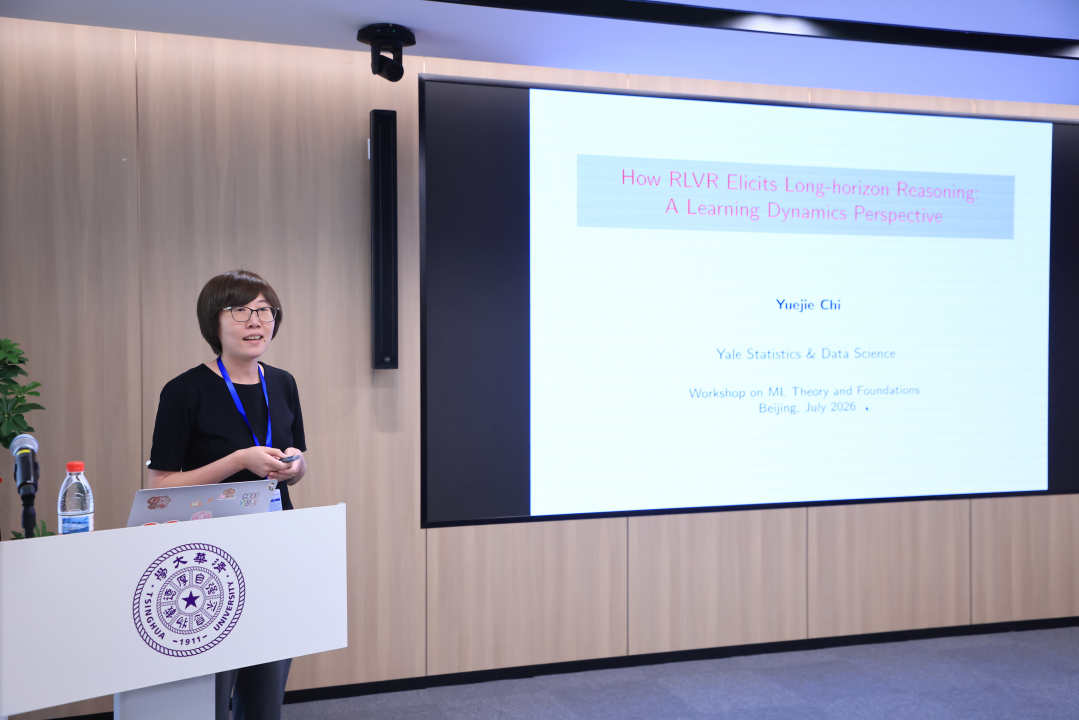
Yuejie Chi教授进行报告
牛津大学Denny Wu副教授作题为"Understanding the Mechanisms of Fast Hyperparameter Transfer"的报告,聚焦深度学习中超参数跨规模迁移的机制。他提出通过分解优化轨迹理解快速迁移现象,讨论宽度稳定成分与宽度敏感成分在损失下降中的不同作用,并结合大语言模型预训练实验展示了这一假说的经验依据。
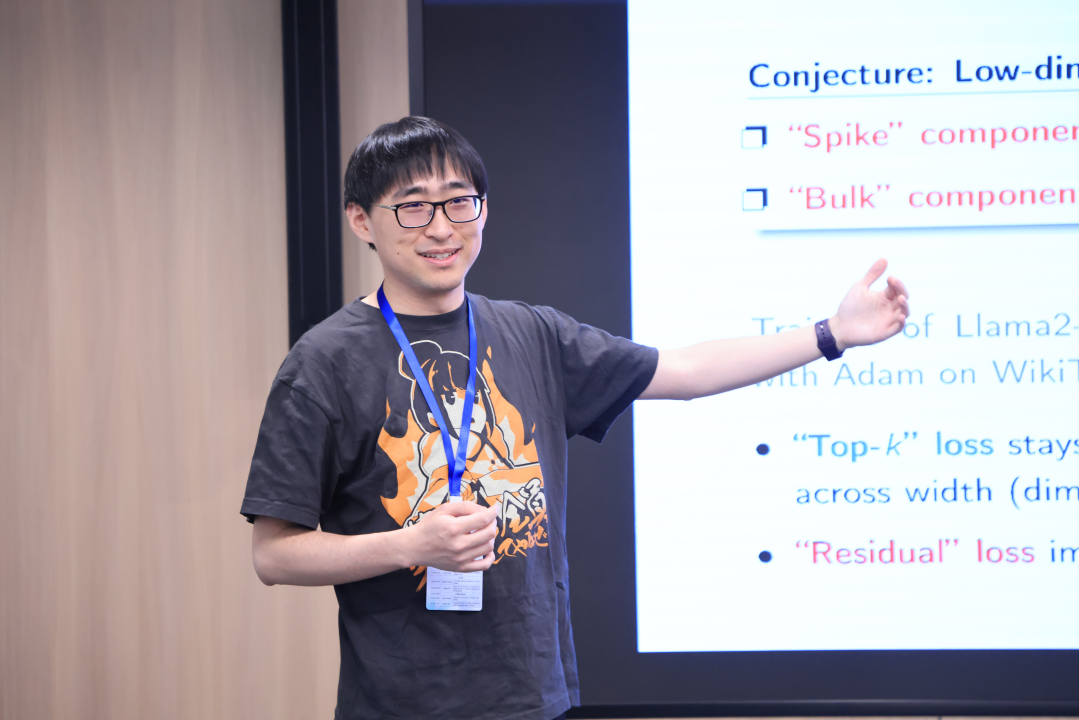
Denny Wu副教授进行报告
报告期间,与会师生围绕大模型可解释性、扩散模型采样效率、强化学习训练机制、过参数化与特征学习、超参数迁移等问题展开交流讨论。本次研讨会聚焦机器学习基础理论与基础模型发展的关键问题,汇聚统计学、计算机科学、信息论、优化理论和人工智能等多个领域的研究力量,为海内外学者搭建了高水平学术交流平台。
编辑|冯冉、黄栋
审核|杨朋昆、侯琳、李乐飞